物种播种
服务器自己结算战斗。它应用伤害公式,抽取 随机伤害浮动,决定暴击,并为每只被捕捉的怪物抽取个体值、性格、 性别和是否闪光。要做到这一切,它需要你每个物种的 基础能力值、属性、捕获率和性别比例。
它不会从客户端获取这些数据。 一个可以发送自己物种能力值的客户端 可以发送任何它想发的东西,所以服务器拒绝从战斗载荷中读取 这些数据。它从自己的存储中读取 —— 而那一开始是空的。
如果跳过这一步会怎样
没有任何可见的现象。而这正是在其他一切之前就值得理解的问题。
未播种的服务器不会报错、不会警告,也不会拒绝开始战斗。它沿着 一条回退链往下走:
species_data存储 —— 已播种的值,你的真实数据。SPECIES_FALLBACK_TABLE—— 六个内置物种,为服务器模块自己的测试 而硬编码在其中。DEFAULT_SPECIES—— 应用于其他所有物种的一行通用能力值。
于是,未播种的服务器会高高兴兴地运行这样的战斗:你的每一只生物
都拥有相同的占位能力值。无论物种是什么,捕捉都按固定的 50/50 抽取性别。
属性相克按 NORMAL 来结算。没有人
会收到错误消息,因为从服务器的角度来看,没有任何事情
出错:它询问了存储,存储里什么都没有,它就使用了默认值。
播种就是让权威服务器对你的游戏而不是一个占位符拥有权威的东西。
两半,以及它们为何分开
播种被有意地分为 Unity 内的导出步骤和 Unity 之外的播种 步骤。
播种 RPC(mce_species_seed)仅限服务器对服务器 —— 它拒绝任何
携带用户会话的调用,并要求 Nakama 运行时的 HTTP 密钥。该
密钥是管理员凭据:谁持有它,谁就可以写入任何玩家的存储。
它绝不能被提交,绝不能嵌入构建,也绝不能
输入到 ScriptableObject 中。
所以无法安全保管该密钥的 Unity 只写出一个文件。从你的终端运行、 从环境变量读取密钥的脚本把它发送出去。
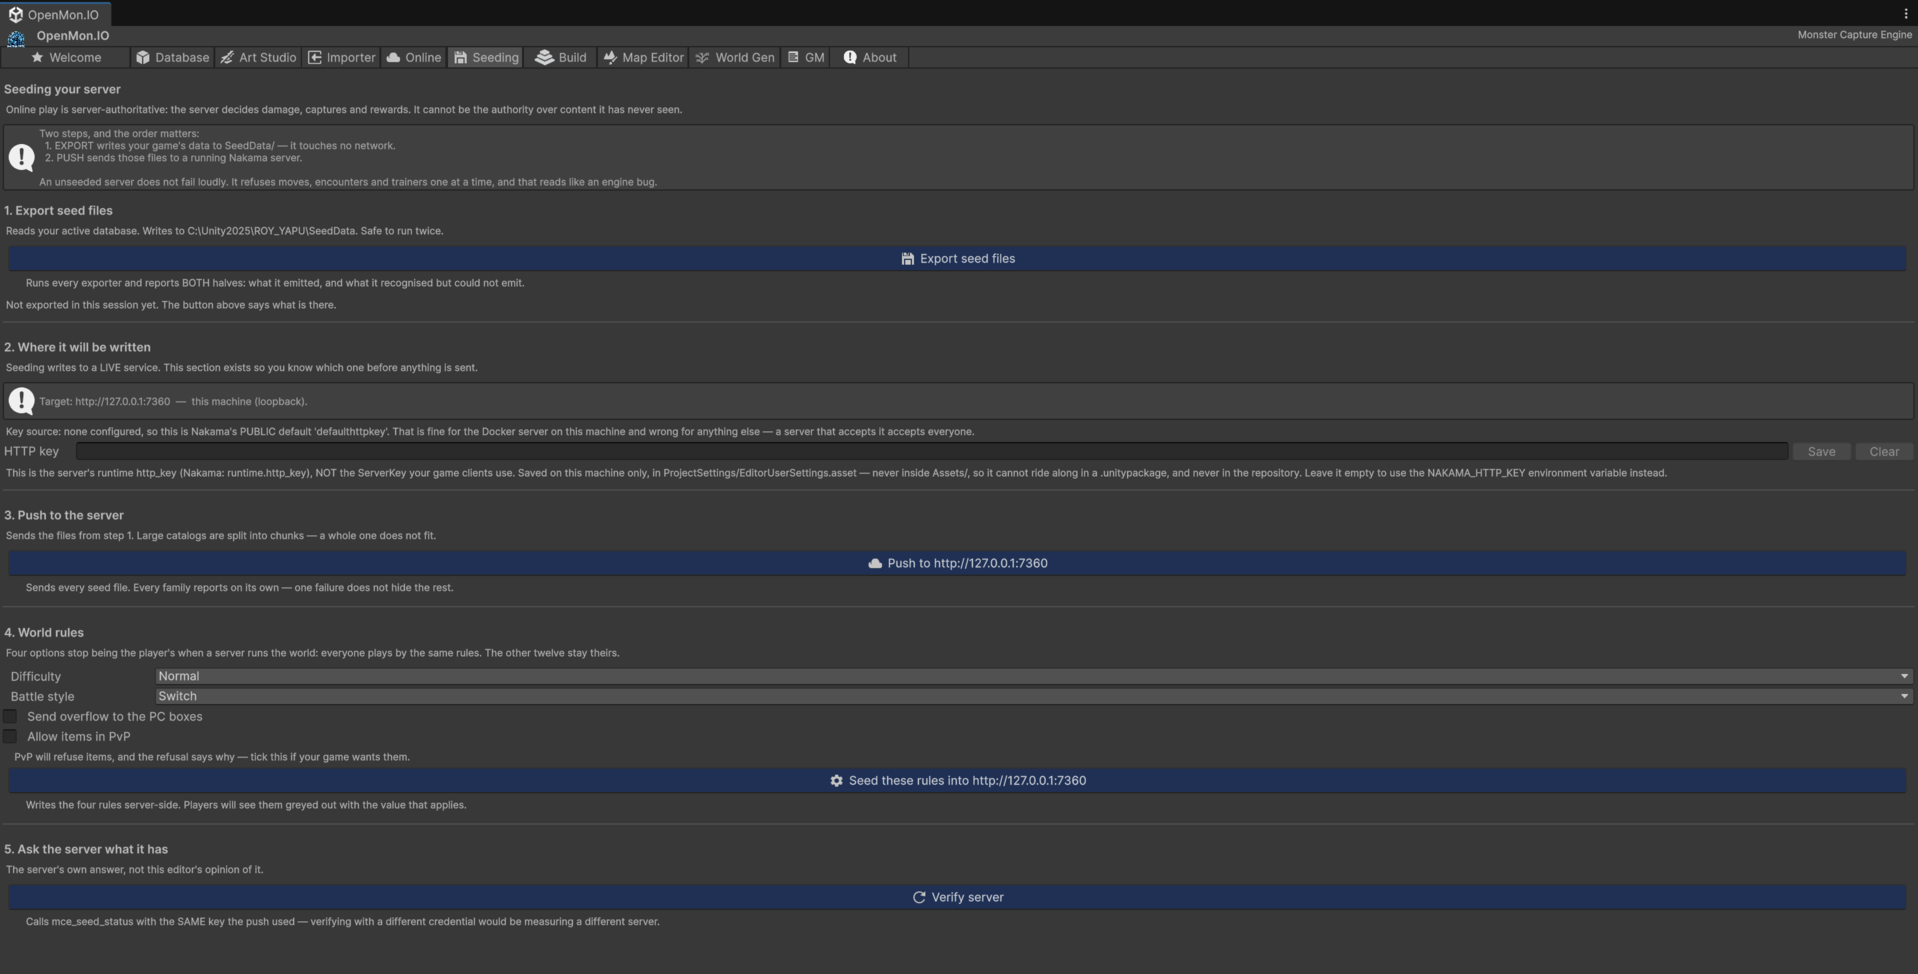
Hub 的 Seeding 选项卡是下面所有内容的面向购买者的路径:它 导出文件并报告服务器当前持有的内容。
步骤 1 —— 从 Unity 导出
Hub:Online 选项卡 → Species Data → Export Species Seed JSON(或 Seeding 选项卡的 Export seed files,它会运行所有导出器,包括物种)。
它会读取当前活动的怪物数据库,并把两个文件写入项目根目录的 SeedData/
—— 有意放在 Assets/ 之外,这样 Unity 就不会导入
它们,并且它们受到 .gitignore 的保护:
| 文件 | 内容 |
|---|---|
species-seed.json | 要发送的载荷 |
species-seed.report.txt | 每个被跳过的条目,以及服务器将替换的每个值 |
请阅读报告。 服务器会把每项能力值限制在 1–255 之间,并对超出该范围的任何值 悄悄地代入它自己的默认值。如果你的某个物种 的基础能力值为 0,该值会在服务器上被替换,而报告是 整个流程中你唯一会看到提及它的地方。
当条目没有图鉴编号、与另一个条目共用 图鉴编号、没有形态或没有第一属性时,它们会被跳过而不是导出。这些 情况中的每一个都会在报告中按名称列出。
只导出每个物种的基础形态。服务器仅以图鉴编号为键存储物种 数据,所以为备用形态添加的第二行 会覆盖第一行。
步骤 2 —— 为服务器播种
在 Assets/OpenMon/Online/Server~/nakama/ 中:
# bash
export NAKAMA_HTTP_KEY=your-runtime-http-key
npm run seed:species
# PowerShell
$env:NAKAMA_HTTP_KEY="your-runtime-http-key"
npm run seed:species
脚本在发送任何内容之前先验证文件,并且当它 发现服务器会悄悄替换的值时拒绝播种。然后它分块 发送物种,因为 RPC 会把每个请求变成一次存储写入,而把整本 图鉴放在一次写入里,正是 Nakama 开始拒绝的地方。
| 变量 | 默认值 | 含义 |
|---|---|---|
NAKAMA_HTTP_KEY | — | 必需。服务器的运行时 http_key。 |
NAKAMA_URL | http://127.0.0.1:7360 | 服务器基础 URL。 |
SEED_FILE | SeedData/species-seed.json | 备用输入路径。 |
SEED_CHUNK_SIZE | 100 | 每个请求的物种数。 |
要在不发送任何内容的情况下验证导出:
npm run seed:species:check
播种是幂等的。每个物种都写在它自己的键下,所以在添加生物之后重新运行 会更新有变化的行,并让其余的保持不动。每当你的数据库变化时 都再运行一次 —— 这是正常的工作流程,而不是恢复 步骤。
步骤 3 —— 验证
打开 OpenMon Hub。内容选项卡会报告两件事,它们回答的 是不同的问题。
第一个是本地且即时的。它把磁盘上的导出与你的 活动数据库进行比较,完全不需要网络。这能抓到 在实践中真正会发生的失败:不是一次错误的播种,而是几周前写出的导出 之后又新增了四十只生物。对线上服务器的检查看不到这一点,因为 服务器并不知道你的项目里有什么。
第二个是 Verify server 按钮,只有它会接触网络。它区分 三种结果,而这个区分很重要:
| 结果 | 含义 |
|---|---|
| Seeded | 集合中有物种行,并且会说明有多少行。 |
| Empty | 服务器作出了回答。它的集合是空的。 |
| Could not ask | 离线、主机错误、服务器密钥错误。这对数据本身什么也没说。 |
“未播种”和“没有回应”是不同的事实。把它们合并的 状态灯比没有状态灯更糟,因为当 真正的问题是网络问题时,它报告的却是数据问题。
你也可以直接对数据库进行验证:
select count(*) from storage where collection = 'species_data';
已播种的行以 Nakama 系统用户的身份写入,具有公开读取和 仅服务器写入的权限,所以客户端可以读取物种数据,但任何客户端都 不可能写入它。
何时重新播种
- 添加、移除或重命名物种之后
- 更改基础能力值、属性、捕获率或性别比例之后
- 使用 Essentials 导入器导入项目之后
- 每次全新的服务器部署 —— 新数据库一开始是空的