Siembra de especies
El servidor resuelve las batallas por sí mismo. Aplica la fórmula de daño, saca la variación aleatoria del daño, decide los golpes críticos y saca los IV, la naturaleza, el género y el carácter shiny de cada monstruo capturado. Para hacer todo eso necesita las estadísticas base, los tipos, la tasa de captura y la proporción de géneros de cada una de tus especies.
No las obtiene del cliente. Un cliente que pudiera enviar las estadísticas de sus propias especies podría enviar lo que quisiera, así que el servidor se niega a leerlas de la carga útil de una batalla. Las lee de su propio almacenamiento, que empieza vacío.
Qué ocurre si te saltas esto
Nada visible. Ese es el problema que conviene entender antes que nada.
Un servidor sin sembrar no da error, ni avisa, ni se niega a iniciar una batalla. Recorre una cadena de alternativas:
- El almacenamiento
species_data: los valores sembrados, tus datos reales. SPECIES_FALLBACK_TABLE: seis especies integradas, codificadas en el módulo del servidor para sus propias pruebas.DEFAULT_SPECIES: una línea de estadísticas genérica que se aplica a todo lo demás.
Así que un servidor sin sembrar ejecuta con toda naturalidad batallas en las que cada una de tus criaturas
tiene estadísticas de relleno idénticas. Las capturas sacan su género con un 50/50 plano
sin importar la especie. La efectividad de tipos se resuelve contra NORMAL. Nadie
recibe un mensaje de error, porque desde el punto de vista del servidor no
salió nada mal: preguntó al almacenamiento, el almacenamiento no tenía nada y usó un valor por defecto.
La siembra es lo que hace que el servidor autoritativo lo sea sobre tu juego y no sobre un marcador de posición.
Las dos mitades, y por qué están separadas
La siembra se divide deliberadamente en un paso de exportación dentro de Unity y un paso de siembra fuera de él.
La RPC de siembra (mce_species_seed) es solo de servidor a servidor: rechaza cualquier
llamada que lleve una sesión de usuario y exige la clave HTTP del runtime de Nakama. Esa
clave es una credencial de administrador: quien la tenga puede escribir en el almacenamiento de cualquier jugador.
Nunca debe confirmarse en el repositorio, nunca incrustarse en una compilación y nunca
escribirse en un ScriptableObject.
Por eso Unity, que no puede guardar esa clave de forma segura, solo escribe un archivo. Un script ejecutado desde tu terminal, que lee la clave del entorno, lo envía.
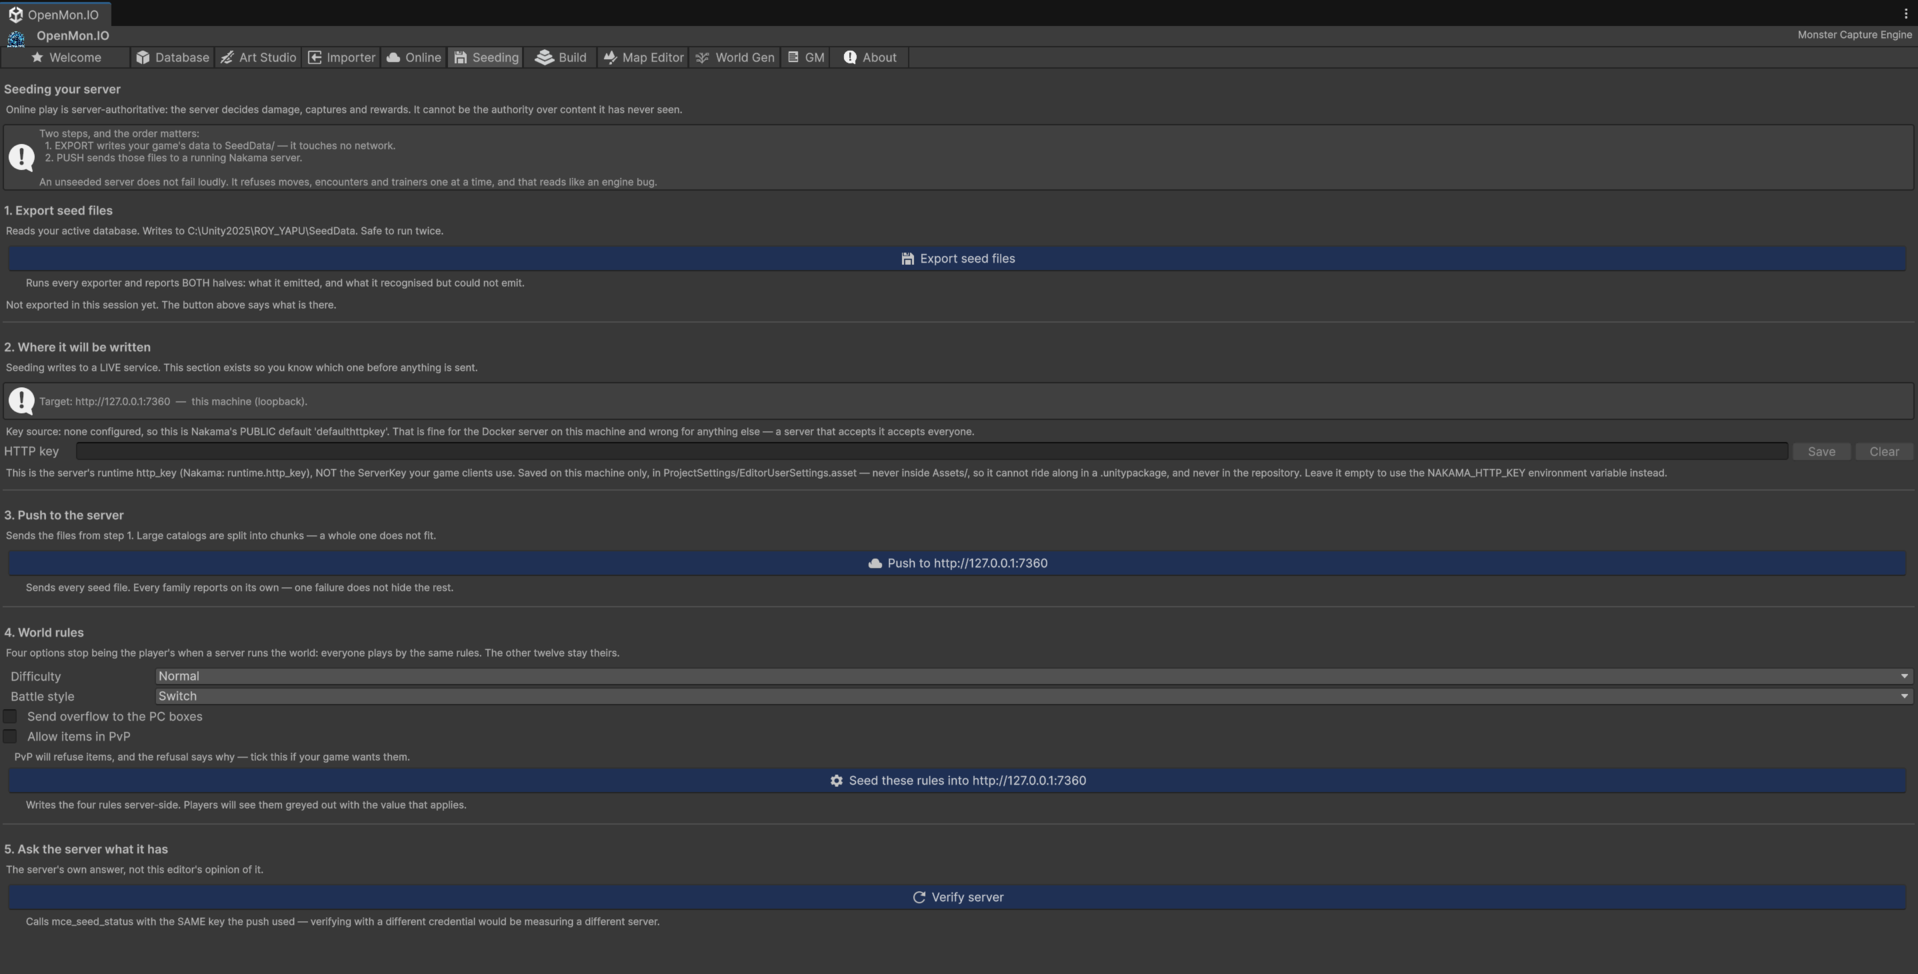
La pestaña Seeding del Hub es el camino orientado al comprador para todo lo que sigue: exporta los archivos e informa de lo que tiene el servidor en este momento.
Paso 1: exportar desde Unity
Hub: pestaña Online → Species Data → Export Species Seed JSON (o el Export seed files de la pestaña Seeding, que ejecuta todos los exportadores, incluido el de especies).
Esto lee la base de datos de monstruos activa y escribe dos archivos en SeedData/
en la raíz de tu proyecto, deliberadamente fuera de Assets/, de modo que Unity nunca los importe
y queden cubiertos por .gitignore:
| Archivo | Contenido |
|---|---|
species-seed.json | La carga útil que se envía |
species-seed.report.txt | Cada entrada omitida y cada valor que el servidor reemplazará |
Lee el informe. El servidor limita cada estadística al rango 1-255 y sustituye por su propio valor por defecto todo lo que quede fuera de ese rango, en silencio. Si una de tus especies tiene una estadística base de 0, ese valor se reemplazará en el servidor y el informe es el único lugar de todo el flujo donde verás que se mencione.
Las entradas se omiten en lugar de exportarse cuando no tienen número de dex, comparten un número de dex con otra entrada, no tienen formas o no tienen primer tipo. Cada uno de esos casos aparece por su nombre en el informe.
Solo se exporta la forma base de cada especie. El servidor guarda los datos de especie solo bajo el número de dex, así que una segunda fila para una forma alternativa sobrescribiría la primera.
Paso 2: sembrar el servidor
Desde Assets/OpenMon/Online/Server~/nakama/:
# bash
export NAKAMA_HTTP_KEY=your-runtime-http-key
npm run seed:species
# PowerShell
$env:NAKAMA_HTTP_KEY="your-runtime-http-key"
npm run seed:species
El script valida el archivo antes de enviar nada y se niega a sembrar cuando encuentra un valor que el servidor reemplazaría en silencio. Luego envía las especies en fragmentos, porque la RPC convierte cada petición en una única escritura de almacenamiento y una dex completa en una sola escritura es donde Nakama empieza a rechazar.
| Variable | Por defecto | Significado |
|---|---|---|
NAKAMA_HTTP_KEY | — | Obligatoria. El http_key del runtime del servidor. |
NAKAMA_URL | http://127.0.0.1:7360 | URL base del servidor. |
SEED_FILE | SeedData/species-seed.json | Ruta de entrada alternativa. |
SEED_CHUNK_SIZE | 100 | Especies por petición. |
Para validar la exportación sin enviar nada:
npm run seed:species:check
La siembra es idempotente. Cada especie se escribe bajo su propia clave, así que volver a ejecutarla después de agregar criaturas actualiza las filas que cambiaron y deja el resto en paz. Ejecútala de nuevo cada vez que cambie tu base de datos: ese es el flujo normal, no un paso de recuperación.
Paso 3: verificar
Abre el OpenMon Hub. La pestaña de contenido informa de dos cosas, y responden a preguntas distintas.
La primera es local e instantánea. Compara la exportación en disco con tu base de datos activa y no necesita red en absoluto. Esto es lo que detecta el fallo que realmente ocurre en la práctica: no una mala siembra, sino una exportación escrita hace semanas seguida de cuarenta criaturas nuevas. Una comprobación en vivo del servidor no puede verlo, ya que el servidor no tiene idea de qué contiene tu proyecto.
La segunda es el botón Verify server, y solo él toca la red. Distingue tres resultados, y la distinción importa:
| Resultado | Significado |
|---|---|
| Seeded | La colección contiene filas de especies, y dice cuántas. |
| Empty | El servidor respondió. Su colección está vacía. |
| Could not ask | Sin conexión, host incorrecto, clave del servidor incorrecta. Esto no dice nada sobre los datos. |
"No sembrado" y "sin respuesta" son hechos distintos. Una luz de estado que los fusiona es peor que ninguna luz de estado, porque informa de un problema de datos cuando el problema real es de red.
También puedes verificar directamente contra la base de datos:
select count(*) from storage where collection = 'species_data';
Las filas sembradas se escriben bajo el usuario del sistema de Nakama con lectura pública y permiso de escritura solo del servidor, de modo que los clientes pueden leer los datos de especies pero ningún cliente puede escribirlos jamás.
Cuándo volver a sembrar
- Después de agregar, quitar o renombrar especies
- Después de cambiar estadísticas base, tipos, tasa de captura o proporción de géneros
- Después de importar un proyecto con el Essentials importer
- En cada despliegue nuevo de un servidor: una base de datos nueva empieza vacía